Embedding คืออะไร? ทำไม AI ถึง “เข้าใจ” ความหมายของคำได้ — อธิบายแบบเห็นภาพ
จากรายงาน Efficient Estimation of Word Representations in Vector Space (Mikolov et al., 2013) งานวิจัยที่เปลี่ยนวงการ NLP ไปตลอดกาล — การที่ AI สามารถคำนวณได้ว่า “กษัตริย์ – ผู้ชาย + ผู้หญิง = ราชินี” คือหลักฐานที่พิสูจน์ว่าโมเดลภาษาไม่ได้แค่ “จำคำ” แต่เรียนรู้โครงสร้างความหมายที่ซับซ้อนจากข้อมูลขนาดใหญ่ได้จริง ทั้งหมดนี้เกิดขึ้นได้เพราะ Embedding
Embedding คือหัวใจที่ซ่อนอยู่เบื้องหลัง ChatGPT, Google Search, Netflix Recommendation, Spotify Discover Weekly — และทุก AI ที่ “เข้าใจ” ความหมายของสิ่งที่คุณพิมพ์ บทความนี้จะอธิบายให้คุณเห็นภาพตั้งแต่ต้น ว่า Embedding คืออะไร ทำงานอย่างไร และนำไปใช้งานจริงได้แบบไหน
Embedding คืออะไร? นิยามแบบบ้านๆ ที่จำได้ทันที
ลองนึกถึงแผนที่โลก แต่ละประเทศมีพิกัดที่ชัดเจน — ไทยอยู่ที่ละติจูด 15°N ลองจิจูด 100°E ฝรั่งเศสอยู่ที่ 46°N 2°E ประเทศที่อยู่ใกล้กันบนแผนที่มักมีวัฒนธรรมและภาษาที่คล้ายกันมากกว่าประเทศที่อยู่ไกลกัน
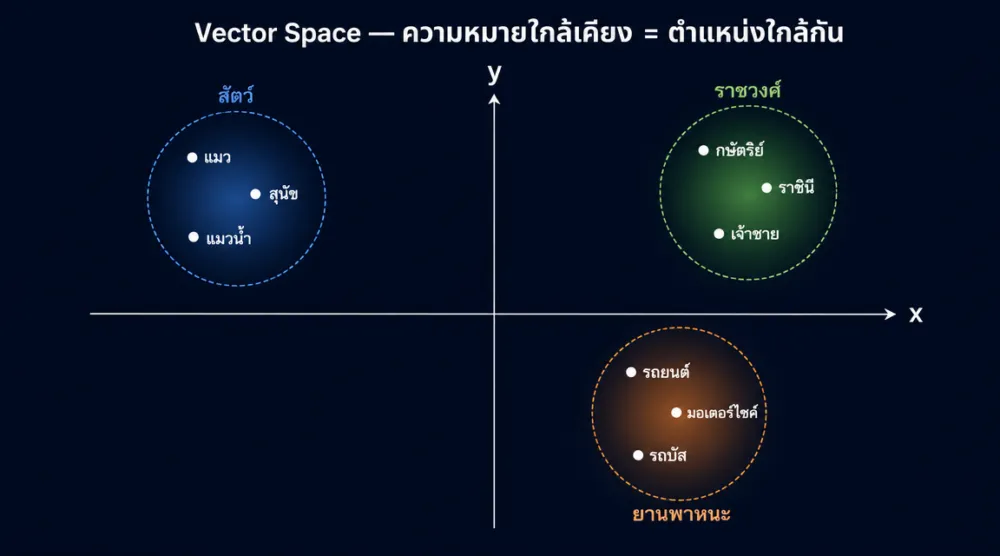
Embedding ทำสิ่งเดียวกันนี้กับภาษา — มันแปลงคำ, ประโยค, หรือเอกสารทั้งชิ้นให้กลายเป็น พิกัดในอวกาศหลายมิติ (N-dimensional space) โดยที่ความหมายที่ใกล้เคียงกัน = พิกัดที่ใกล้กันใน space นั้น
ตัวอย่างเป็นรูปธรรม: ถ้า vector ของ “แมว” คือ [0.8, 0.2, 0.9, …] และ vector ของ “สุนัข” คือ [0.75, 0.25, 0.88, …] ตัวเลขทั้งสองชุดจะ “ใกล้กัน” มากกว่า vector ของ “รถยนต์” ซึ่งอาจเป็น [-0.3, 0.9, 0.1, …] ความใกล้-ไกลนี้วัดได้ด้วยคณิตศาสตร์ เรียกว่า cosine similarity หรือ dot product
ในชีวิตจริง embedding model สมัยใหม่อย่าง OpenAI text-embedding-3-small สร้าง vector ที่มี 1,536 มิติ — หมายความว่าคำแต่ละคำถูกแทนด้วยตัวเลข 1,536 ตัว แต่ละมิติจับ “แง่มุม” ต่างๆ ของความหมาย เช่น ความเป็น animate/inanimate, ความเป็น positive/negative, domain ที่เกี่ยวข้อง ฯลฯ
สรุปสั้นๆ: Embedding = การแปลง “ความหมาย” ให้กลายเป็น “ตัวเลข” ที่คำนวณได้
สำหรับผู้ที่เพิ่งเริ่มทำความรู้จักกับ Embedding มีคำศัพท์ที่เกี่ยวข้อง 4 ตัวที่ควรรู้ก่อน:
- Dense Vector: vector ที่ทุกมิติมีค่าตัวเลขที่มีความหมาย (ตรงข้ามกับ Sparse Vector อย่าง One-Hot Encoding ที่ส่วนใหญ่เป็น 0)
- Cosine Similarity: วิธีวัด “ความใกล้เคียง” ระหว่าง 2 vector โดยวัดมุมระหว่างทั้งสองใน space — ค่า 1.0 = ทิศทางเดียวกัน (ความหมายเหมือนกัน), ค่า 0 = ไม่เกี่ยวข้องกัน, ค่า -1.0 = ตรงข้ามกัน
- Vector Space: อวกาศ N มิติที่ embedding ทุกตัวอาศัยอยู่ เปรียบเหมือน “แผนที่ความหมาย” ขนาดใหญ่ที่ทุกคำมีพิกัดของตัวเอง
- Semantic Similarity: การวัดความใกล้เคียงของ “ความหมาย” ระหว่างสองข้อความ คำนวณจากระยะห่างระหว่าง embedding ทั้งสอง
ทำไม “กษัตริย์ – ผู้ชาย + ผู้หญิง = ราชินี” ถึงเป็นไปได้? เรขาคณิตแห่งความหมาย
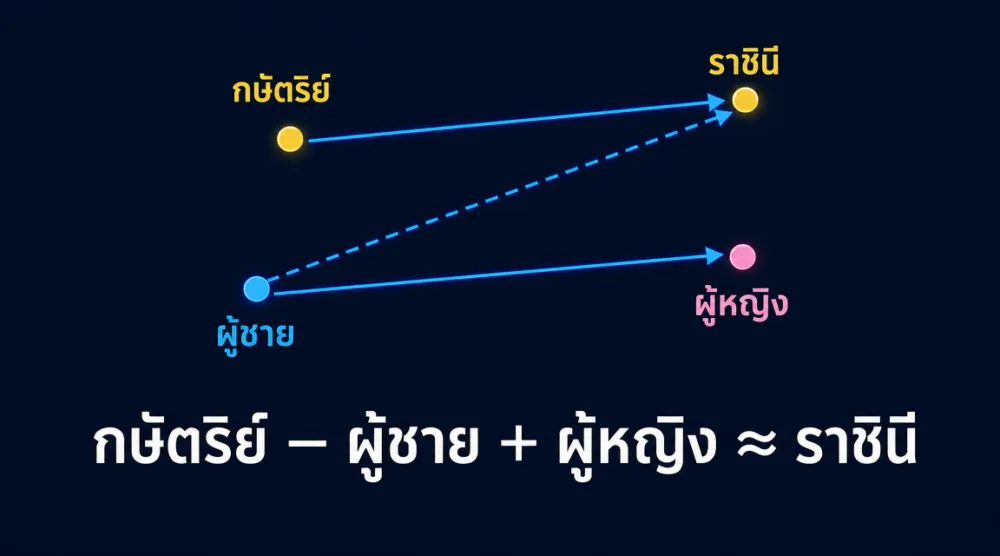
ปรากฏการณ์นี้ที่นักวิจัยเรียกว่า word analogy arithmetic คือหนึ่งในการค้นพบที่ตะลึงที่สุดในประวัติศาสตร์ AI มันแสดงให้เห็นว่า embedding ไม่ได้แค่วางคำสุ่มๆ ในอวกาศ แต่จับ ความสัมพันธ์เชิงโครงสร้าง ได้ด้วย
ลองนึกภาพ vector space แบบง่ายๆ:
- vector(กษัตริย์) อยู่ที่ตำแหน่งหนึ่งใน space
- vector(ราชินี) อยู่ใกล้กัน แต่ต่างกันในมิติที่แทน “เพศ”
- vector(ผู้ชาย) และ vector(ผู้หญิง) ต่างกันในมิติเดียวกันนั้น
เมื่อคำนวณ: vector(กษัตริย์) - vector(ผู้ชาย) จะได้ vector ที่แทน “ความเป็นราชวงศ์” โดยปราศจากมิติเพศ เมื่อ + vector(ผู้หญิง) เข้าไป จะได้พิกัดที่ใกล้ vector(ราชินี) มากที่สุดใน space ทั้งหมด
ทำไมมันถึงทำงานได้? เพราะโมเดลถูกฝึกด้วยข้อความมหาศาล และในข้อความนั้น คู่คำ “กษัตริย์/ราชินี” มักปรากฏในบริบทเดียวกับ “ผู้ชาย/ผู้หญิง” หลายล้านครั้ง โมเดลจึงเรียนรู้ว่าความสัมพันธ์ระหว่างสองคู่นี้มีทิศทางและขนาดที่ใกล้เคียงกันใน space
ตัวอย่างอื่นที่ทดสอบแล้วได้ผล:
- กรุงเทพ – ไทย + ฝรั่งเศส ≈ ปารีส (เมืองหลวงของประเทศ)
- ว่ายน้ำ – ว่าย + วิ่ง ≈ วิ่ง (verb conjugation pattern)
- หมอ – โรงพยาบาล + โรงเรียน ≈ ครู (อาชีพตามสถาบัน)
นี่คือความแตกต่างที่สำคัญระหว่าง “AI ที่จำ” กับ “AI ที่เข้าใจ” — Embedding ไม่ได้จำว่า “คำนี้มีความหมายว่าอะไร” แต่เรียนรู้ว่า “คำนี้สัมพันธ์กับคำอื่นๆ อย่างไร” และนั่นคือสาระสำคัญของความเข้าใจภาษา
Embedding Model เรียนรู้ได้อย่างไร? เบื้องหลังแบบไม่ต้องใช้สูตรคณิตศาสตร์
โมเดล Embedding รุ่นแรกๆ อย่าง Word2Vec ของ Google (2013) ใช้ idea ง่ายๆ ที่เรียกว่า “Distributional Hypothesis” — คำที่ปรากฏในบริบทเดียวกันมักมีความหมายใกล้เคียงกัน หรือที่นักภาษาศาสตร์ John Firth พูดไว้ว่า “You shall know a word by the company it keeps.”
กระบวนการเรียนรู้แบบง่ายๆ คือ:
- ป้อนข้อความมหาศาล — Wikipedia, หนังสือ, เว็บไซต์ หลายพันล้านประโยค
- ตั้ง task ง่ายๆ — เช่น “ดูคำแวดล้อม 5 คำ แล้วทายว่าคำกลางคืออะไร?” หรือ “ดูคำหนึ่งคำ แล้วทายว่าคำข้างเคียงน่าจะเป็นอะไร?”
- ปรับค่า vector — โมเดลปรับตัวเลขในแต่ละมิติทีละน้อยตลอดการฝึก เพื่อทำให้ทาย task ข้อ 2 แม่นขึ้น
- ผลพลอยได้คือ vector ที่มีความหมาย — เมื่อฝึกเสร็จ vector ที่ได้จับความสัมพันธ์เชิงความหมายโดยอัตโนมัติ
สิ่งที่น่าทึ่งที่สุดคือ โมเดลไม่เคยได้รับคำสอนว่า “กษัตริย์” หมายความว่าอะไร — มันเรียนรู้เองจากการสังเกตว่าคำนี้ปรากฏร่วมกับคำอะไรบ้าง ในบริบทไหนบ้าง หลายร้อยล้านครั้ง
จุดเปลี่ยนสำคัญมาในปี 2018 เมื่อ Google เปิดตัว BERT (Bidirectional Encoder Representations from Transformers) ซึ่งเปลี่ยนจาก “static embedding” (คำหนึ่งคำ = vector หนึ่งตัวเสมอ) ไปเป็น “contextual embedding” — คำเดียวกันอาจได้ vector ต่างกันตามบริบท เช่น “แบงก์” ในประโยค “ฝากเงินที่แบงก์” กับ “แบงก์ข้าวกินก่อน” จะได้ vector คนละตัว เพราะความหมายต่างกันโดยสิ้นเชิง
โมเดลสมัยใหม่อย่าง Sentence Transformers ก้าวต่ออีกขั้นด้วย Contrastive Learning — โมเดลถูกฝึกโดยให้ “ดัน” ประโยคที่ paraphrase กันให้อยู่ใกล้กันใน space และ “ผลัก” ประโยคที่ไม่เกี่ยวข้องกันออกห่าง เทคนิคนี้ (เช่น SimCSE จาก Princeton 2021) ทำให้ embedding จับ semantic similarity ในระดับประโยคได้แม่นกว่า word2vec อย่างมาก ซึ่งเป็นพื้นฐานของระบบ RAG สมัยใหม่ทุกตัว
ถ้าสนใจเรื่อง NLP เชิงลึกมากกว่านี้ หลักสูตร เจาะข้อมูลทางภาษา หา insight ใน data ด้วย NLP บน FutureSkill วางรากฐานตั้งแต่ text preprocessing ไปจนถึง transformer-based models อย่างเป็นระบบ
Embedding ใช้ทำอะไรได้บ้างในชีวิตจริง? 5 Use Case ที่เปลี่ยนเกม
ตลาด Embedding API ทั่วโลกถูกคาดการณ์ว่าจะเติบโตอย่างมีนัยสำคัญ เพราะมันเป็น “โครงสร้างพื้นฐาน” ของ AI application สมัยใหม่เกือบทุกประเภท ต่อไปนี้คือ 5 use case หลักที่ใช้งานจริงในองค์กร
1. Semantic Search — ค้นหาด้วยความหมาย ไม่ใช่ keyword
การค้นหาแบบเดิม (keyword search) จับคู่คำตามตัวอักษร — ถ้าคุณพิมพ์ “วิธีลดน้ำหนัก” แต่เอกสารใช้คำว่า “การควบคุมน้ำหนัก” ก็อาจค้นไม่เจอ
Semantic search ด้วย Embedding แปลงทั้งคำค้นหาและเอกสารเป็น vector ก่อน แล้วเปรียบเทียบ “ทิศทาง” ของ vector ในอวกาศ ทำให้ “วิธีลดน้ำหนัก” และ “การควบคุมน้ำหนัก” อยู่ใกล้กันใน space และค้นเจอกันได้ แม้ใช้คำต่างกัน
ตัวอย่างที่เห็นชัด: Google Search ใช้ technique นี้มาตั้งแต่ยุค BERT (2019) ทำให้เข้าใจ intent ของคำค้นหาได้แม่นกว่าเดิมมาก
2. RAG Pipeline — พลังงานที่ขับเคลื่อน AI ที่ตอบจากเอกสารของคุณ
RAG (Retrieval-Augmented Generation) คือ technique ที่ให้ AI ค้นหาข้อมูลที่เกี่ยวข้องก่อน แล้วค่อยตอบคำถาม — และ Embedding คือ “เครื่องยนต์” ที่ทำให้การค้นหาส่วนนั้นทำงานได้
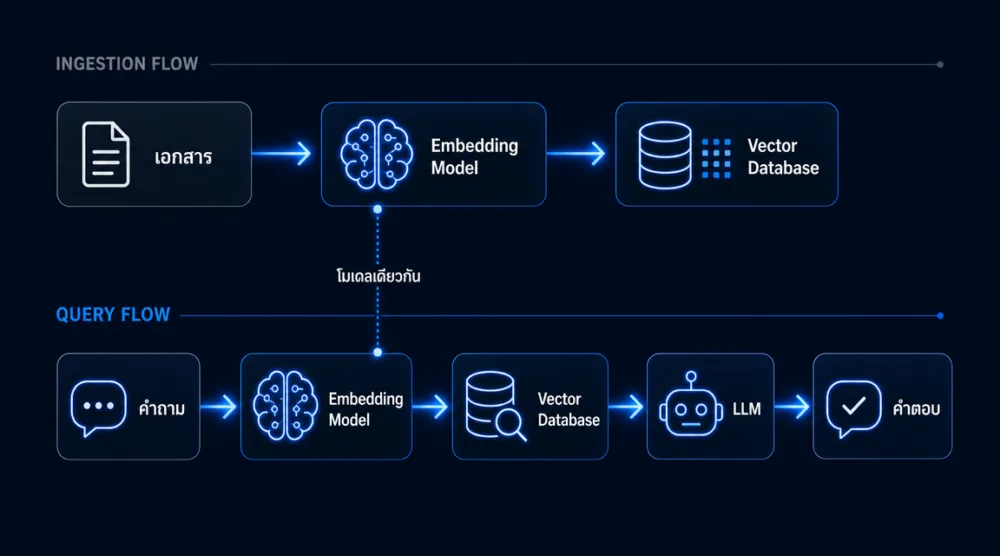
กระบวนการทำงานคือ: เอกสารทุกชิ้นถูกแปลงเป็น embedding และเก็บไว้ใน vector database เมื่อผู้ใช้ถามคำถาม คำถามนั้นก็ถูกแปลงเป็น embedding เช่นกัน แล้วระบบค้นหาเอกสาร/ชิ้นส่วนที่ embedding ใกล้เคียงกันที่สุด ก่อนส่งให้ LLM สร้างคำตอบ
โดยไม่มี Embedding ที่ดี RAG จะค้นหาเอกสารผิดมา และคำตอบจะผิดตามไปด้วย — Embedding คือ “ความแม่นยำ” ของทั้งระบบ ถ้าสนใจสร้าง RAG ระบบแรก หลักสูตร สร้าง RAG AI Agent จากข้อมูลของคุณ พาคุณจาก embedding → vector database → RAG pipeline ทั้งหมดใน step เดียว
3. Recommendation System — แนะนำสิ่งที่ “ใกล้เคียง” กับที่คุณชอบ
Netflix, Spotify, Shopee ใช้ Embedding ในการ recommend content Spotify แปลง listening history ของคุณเป็น “user embedding” — vector ที่แทน taste ทางดนตรีของคุณในอวกาศ เพลงแต่ละเพลงก็มี “song embedding” ที่แทน style, genre, mood
เมื่อ user embedding ของคุณใกล้กับ song embedding ของเพลงไหน ระบบก็จะแนะนำเพลงนั้น — ไม่ใช่เพราะคุณเคยฟัง แต่เพราะ “ตำแหน่ง” ในอวกาศบอกว่าคุณน่าจะชอบ
ในอีคอมเมิร์ซ เทคนิคเดียวกันนี้ใช้ match ผู้ซื้อกับสินค้า โดย embed ทั้งประวัติการซื้อ และคำอธิบายสินค้า ทำให้ recommend ได้ “อย่างเป็นธรรมชาติ” มากกว่า rule-based system แบบเดิม
4. Duplicate Detection และ Clustering — จัดกลุ่มเอกสารที่มีความหมายเดียวกัน
Embedding ยังใช้ detect เอกสารซ้ำ หรือจัดกลุ่มเอกสารที่มีเนื้อหาคล้ายกันได้ โดยไม่ต้องตรวจสอบทีละคู่ด้วยตาคน ตัวอย่างคือ Customer Support ที่มีคำถามลูกค้าหลายพันคำถามต่อวัน — การ cluster ด้วย embedding ช่วยให้เห็นว่าคำถามประเภทไหนมาบ่อยที่สุด เพื่อ prioritize การสร้าง FAQ หรือ automation
ทักษะเหล่านี้เชื่อมโยงกับเส้นทางสายข้อมูลที่กำลังเป็นที่ต้องการ — ดูได้ที่บทความ เส้นทางสู่ Data Scientist ว่า NLP และ Embedding เป็น skill set สำคัญในสายนี้อย่างไร
5. Intent Detection และ Zero-shot Classification — แยกประเภทข้อความโดยไม่ต้องมี labeled data เยอะ
หนึ่งใน use case ที่ทรงพลังที่สุดของ Embedding คือ zero-shot classification — การแยกประเภทข้อความโดยไม่ต้องมีตัวอย่าง labeled data สำหรับแต่ละ category เลย แนวทางคือ: แปลงทั้งข้อความที่ต้องการจัดประเภทและชื่อ category แต่ละตัวเป็น embedding จากนั้นดูว่าข้อความใกล้กับ category ไหนมากที่สุด
ตัวอย่างในงาน Customer Service: ถ้ามีคำถามว่า “สินค้าที่ฉันสั่งยังไม่มาเลย” ระบบสามารถ embed ข้อความนี้และเปรียบเทียบกับ category เช่น “การคืนเงิน”, “สถานะพัสดุ”, “คำถามทั่วไป” — แล้วส่งไปยัง agent ที่ถูกต้องโดยอัตโนมัติ โดยไม่ต้องฝึกโมเดล classification แยกต่างหาก
ความสามารถนี้ยังใช้ใน multilingual context ได้ดีมาก — embedding model ข้ามภาษา (cross-lingual) สามารถ map ความหมายจากหลายภาษามาไว้ใน space เดียวกัน ทำให้ถามเป็นภาษาไทยแต่ค้นหาเอกสารภาษาอังกฤษได้ถูกต้อง ซึ่งมีประโยชน์มากสำหรับองค์กรที่มีเอกสารหลายภาษา ดูแนวทางพัฒนา AI Agent เพิ่มเติมได้ที่หลักสูตร Building Intelligent Assistants: AI Agent Technology
เครื่องมือฟรีที่ลอง Embedding ได้วันนี้ — ไม่ต้องรู้คณิตศาสตร์
ข่าวดีคือ Embedding ในปี 2026 ไม่ใช่เรื่องสำหรับนักวิจัยเท่านั้น มีเครื่องมือฟรีให้ทดลองได้ทันที ต่อไปนี้คือ 4 ตัวที่แนะนำ
1. OpenAI text-embedding-3-small (แนะนำสำหรับ Production)
ดีที่สุดสำหรับ: งาน semantic search และ RAG ภาษาไทย/อังกฤษ
- ราคา: $0.02 ต่อ 1 ล้าน token — ถูกมากสำหรับ production
- มิติ: 1,536 (default) — รองรับ Matryoshka ลด dimension ได้
- รองรับ 100+ ภาษารวมถึงภาษาไทย
- เรียกใช้ผ่าน OpenAI API ด้วย Python 3 บรรทัด
from openai import OpenAI
client = OpenAI()
response = client.embeddings.create(input="แมวชอบกินปลา", model="text-embedding-3-small")
vector = response.data[0].embedding  # list of 1536 floats
2. HuggingFace Sentence Transformers (ฟรี 100% — Run Local)
ดีที่สุดสำหรับ: ทดลอง, งาน offline, ข้อมูล sensitive ที่ไม่อยากส่งออก cloud
- ฟรีทั้งหมด — run บน local machine ได้เลย
- model แนะนำ:
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2รองรับภาษาไทย - community ใหญ่มาก มี model หลายร้อยตัวให้เลือกบน HuggingFace Hub
from sentence_transformers import SentenceTransformer
model = SentenceTransformer('paraphrase-multilingual-MiniLM-L12-v2')
vector = model.encode("แมวชอบกินปลา")  # numpy array
3. Google Generative AI Embedding API
ดีที่สุดสำหรับ: คนที่ใช้ Google Cloud ecosystem อยู่แล้ว
- model:
models/text-embedding-004— ล่าสุดจาก Google - มี free tier ให้ทดลอง
- ใช้ผ่าน
google-generativeaiPython package
4. Cohere Embed v3
ดีที่สุดสำหรับ: งาน multilingual ที่ต้องการ accuracy สูง
- จุดเด่น: ออกแบบมาเพื่อ multilingual โดยเฉพาะ รองรับ 100+ ภาษา
- มี free trial และ embedding endpoint โดยตรง
- รองรับทั้ง semantic search และ classification task
สำหรับคนที่ยังไม่เขียนโค้ดเป็น ลองเริ่มที่ OpenAI Playground — มีตัวอย่าง embedding ที่คุณ visualize ได้ทันที หรือจะลองผ่าน Python notebook บน Google Colab ฟรีก็ได้ โดยไม่ต้องติดตั้งอะไรในเครื่อง สำหรับคนที่อยากพัฒนาทักษะ Data Science ควบคู่ไปด้วย ดูเส้นทางการเรียนได้ที่ คู่มือเริ่มต้นอาชีพ Data Analyst
Embedding กับ Vector Database ทำงานร่วมกันอย่างไร?
เมื่อคุณมี embedding แล้ว คำถามต่อไปคือ “จะเก็บและค้นหา vector เหล่านี้อย่างไร?” นั่นคือที่มาของ Vector Database
Vector Database ถูกออกแบบมาเพื่อ task เดียว: หา vector ที่ใกล้เคียงที่สุดกับ query vector ได้อย่างรวดเร็ว แม้จะมี vector หลายล้านชิ้น เทคนิคที่ใช้เรียกว่า Approximate Nearest Neighbor (ANN) search ซึ่งเร็วกว่าการเปรียบทีละคู่มหาศาล algorithm ที่นิยมใช้ในปัจจุบันคือ HNSW (Hierarchical Navigable Small World) ซึ่งสร้าง “graph” หลายชั้นของ vector เพื่อให้ค้นหาได้เร็วโดยไม่ต้องดูทุกตัว — ทำให้ค้นหาใน 1 ล้าน vector ได้ภายในไม่กี่มิลลิวินาที
ตัวเลือก vector database ที่นิยม:
- Chroma — open-source, ติดตั้งได้ใน local ใน 1 บรรทัด เหมาะสำหรับ prototype และ learning
- Pinecone — managed cloud service ไม่ต้อง maintain infrastructure เหมาะสำหรับ production
- Weaviate — open-source + cloud มี built-in vectorization รองรับ multi-modal data
- Qdrant — performance ดีมาก deploy ได้ทุก environment เหมาะสำหรับ scale ใหญ่
ใน RAG pipeline สมบูรณ์ Embedding model และ Vector Database ทำงานคู่กันดังนี้: Embedding model แปลงข้อความเป็น vector → Vector Database เก็บและค้นหา vector → LLM สร้างคำตอบจาก context ที่ค้นมาได้
ทั้งหมดนี้คือเหตุผลที่ Embedding เป็น prerequisite สำคัญก่อนเรียนรู้เรื่อง RAG คืออะไร — คุณจะเข้าใจ RAG ได้ลึกกว่าเดิมมากเมื่อรู้ว่า Embedding ทำงานอย่างไรเบื้องหลัง
คำถามที่พบบ่อยเกี่ยวกับ Embedding
Embedding ต่างจาก One-Hot Encoding อย่างไร?
One-Hot Encoding คือวิธีเก่าที่แทนคำแต่ละคำด้วย vector ที่มี 1 ตัวเดียวเป็น 1 และที่เหลือเป็น 0 ทั้งหมด เช่น ถ้ามีคำศัพท์ 50,000 คำ vector ของทุกคำจะมีขนาด 50,000 มิติ แต่มีค่าแค่ตำแหน่งเดียวที่ไม่ใช่ศูนย์ ปัญหาหลักคือ One-Hot ไม่แสดงความสัมพันธ์ระหว่างคำ เช่น vector ของ “แมว” กับ “สัตว์เลี้ยง” ไม่ต่างกันเลยจาก “แมว” กับ “รถยนต์” ทั้งๆ ที่ความหมายชัดเจนว่าต่างกัน ส่วน Embedding คือ dense vector ที่มีมิติน้อยกว่ามาก (เช่น 768 หรือ 1,536 มิติ) แต่แต่ละมิติมีค่าต่อเนื่อง และที่สำคัญคือตำแหน่งของ vector สะท้อนความสัมพันธ์เชิงความหมาย คำที่มีความหมายใกล้เคียงกันจะอยู่ใกล้กันใน space จริงๆ Embedding ถูกเรียนรู้จากข้อมูลขนาดใหญ่ ทำให้จับ nuance ของภาษาได้ดีกว่า One-Hot มาก
Embedding model และ LLM ต่างกันอย่างไร?
LLM (Large Language Model) เช่น GPT-4 หรือ Claude ถูกออกแบบมาเพื่อ “สร้าง” ข้อความ — มัน input ข้อความและ output ข้อความถัดไปที่น่าจะเป็นไปได้มากที่สุด ส่วน Embedding model ถูกออกแบบมาเพื่อ “แปลง” ข้อความให้กลายเป็น vector ตัวเลขที่แสดงความหมาย มัน input ข้อความและ output ชุดตัวเลข (เช่น [0.23, -0.45, 0.12, …]) LLM และ Embedding model มักใช้ architecture เดียวกัน (Transformer) แต่ถูก train สำหรับ objective ที่ต่างกัน ในระบบจริงมักใช้ทั้งสองร่วมกัน เช่น ใน RAG pipeline: Embedding model ทำหน้าที่แปลงเอกสารและคำถามเป็น vector เพื่อค้นหาข้อมูลที่เกี่ยวข้อง จากนั้น LLM ทำหน้าที่สังเคราะห์คำตอบจากข้อมูลที่ค้นมาได้
ทำไม Embedding ถึงทำให้ “กษัตริย์ – ผู้ชาย + ผู้หญิง = ราชินี” ได้?
ปรากฏการณ์นี้เรียกว่า word arithmetic หรือ analogy reasoning และเป็นหลักฐานที่แสดงว่า Embedding ไม่ได้แค่จำคำ แต่จับ “ความสัมพันธ์” ระหว่างคำได้ด้วย เหตุผลที่มันทำงานได้คือ โมเดลได้เห็นคู่คำเช่น “กษัตริย์/ราชินี” และ “ผู้ชาย/ผู้หญิง” ในบริบทที่คล้ายกันหลายล้านครั้ง ทำให้ vector ของทั้งสองคู่เรียนรู้ว่า “ความแตกต่าง” ระหว่างกษัตริย์กับราชินี มีทิศทางและขนาดใกล้เคียงกับความแตกต่างระหว่างผู้ชายกับผู้หญิง เมื่อคำนวณ vector(กษัตริย์) – vector(ผู้ชาย) จะได้ vector ที่แทน “ความเป็นราชวงศ์ที่ปราศจากเพศชาย” เมื่อบวก vector(ผู้หญิง) เข้าไป vector ที่ได้จึงอยู่ใกล้ vector(ราชินี) มากที่สุดใน space สิ่งที่ยืนยันคือมันไม่ใช่การท่องจำ แต่เป็นการเรียนรู้โครงสร้างความสัมพันธ์จากข้อมูลจำนวนมาก
Embedding ใช้ภาษาไทยได้ดีแค่ไหน?
คุณภาพของ Embedding สำหรับภาษาไทยขึ้นอยู่กับ model ที่ใช้ Embedding model ทั่วไปอย่าง OpenAI text-embedding-3-small และ text-embedding-3-large รองรับภาษาไทยได้ดีมาก เนื่องจาก OpenAI ใช้ข้อมูลหลายภาษารวมถึงภาษาไทยในการ train Cohere Embed v3 ก็รองรับภาษาไทยได้ดีเช่นกัน สำหรับ use case เฉพาะทาง เช่น ข้อมูลทางการแพทย์หรือกฎหมายไทย อาจต้องพิจารณา fine-tune embedding model บน corpus ภาษาไทยเฉพาะทาง หรือใช้ WangchanBERTa ซึ่งเป็น model ภาษาไทยโดยตรงจาก NECTEC ที่ถูกออกแบบมาสำหรับ NLP ภาษาไทยโดยเฉพาะ สำหรับงาน semantic search ทั่วไปภาษาไทย OpenAI embedding เป็นจุดเริ่มต้นที่ดีและใช้งานได้ทันที
Embedding มีกี่มิติ และมิติที่มากขึ้นหมายความว่าดีกว่าเสมอไหม?
จำนวนมิติของ Embedding (embedding dimension) แตกต่างกันตามโมเดล เช่น text-embedding-3-small ของ OpenAI มี 1,536 มิติ, text-embedding-3-large มี 3,072 มิติ, ส่วน Sentence-Transformers บน HuggingFace มีหลายขนาดตั้งแต่ 384 ถึง 1,024 มิติ มิติที่มากขึ้นไม่ได้หมายความว่าดีกว่าเสมอไป มิติมากขึ้นหมายถึงพื้นที่เก็บข้อมูล (storage) มากขึ้น การคำนวณ similarity ช้าลง และ cost สูงขึ้น โดยเฉพาะเมื่อมีเอกสารหลายล้านชิ้น ในทางปฏิบัติ embedding ที่มี 768–1,536 มิติมักให้ผลดีเพียงพอสำหรับงาน semantic search ทั่วไป OpenAI ยังมีฟีเจอร์ Matryoshka Representation Learning ใน text-embedding-3-small ที่ช่วยให้ truncate มิติลงได้โดยไม่สูญเสียคุณภาพมากนัก ทำให้ประหยัด cost ได้อย่างมีนัยสำคัญ
ต้องใช้ Embedding ตัวเดียวกันในการ index และ query ไหม?
ใช่ — นี่คือกฎเหล็กของการทำ semantic search และ RAG ที่ไม่มีข้อยกเว้น เหตุผลคือแต่ละ Embedding model สร้าง vector space ที่ไม่เหมือนกัน เหมือนกับแผนที่คนละฉบับที่ใช้พิกัดระบบต่างกัน ถ้า index เอกสารด้วย model A vector ของเอกสารทั้งหมดจะอยู่ใน “space ของ model A” เมื่อ query ด้วย model B คำถามจะถูกแปลงเป็น vector ใน “space ของ model B” ซึ่งไม่ compatible กัน การวัด similarity จึงได้ผลลัพธ์ที่ไม่มีความหมาย เหมือนการบวกพิกัด GPS กับพิกัดบนแผนที่คนละระบบ ข้อควรระวังเพิ่มเติมคือ เมื่อต้องการเปลี่ยนไปใช้ Embedding model ใหม่ที่ดีกว่า คุณต้องทำ re-indexing เอกสารทั้งหมดใหม่ด้วย model ใหม่ก่อน ไม่สามารถใช้ index เก่าผสมกับ model ใหม่ได้
Chunking คืออะไร และเกี่ยวข้องกับ Embedding ใน RAG อย่างไร?
Chunking คือกระบวนการตัดเอกสารยาวๆ ให้เป็นชิ้นเล็กๆ (chunk) ก่อนแปลงเป็น embedding เนื่องจาก embedding model ส่วนใหญ่มีขีดจำกัดจำนวน token ที่รับได้ต่อครั้ง และการส่งเอกสารทั้งชิ้นทำให้ได้ embedding ที่ “เฉลี่ย” ความหมายทั้งหมดจนไม่แม่นยำ Chunking ที่ดีต้องคำนึงถึงหลายปัจจัย: ขนาด chunk ที่เล็กเกินไปทำให้ขาด context ส่วนใหญ่เกินไปก็ทำให้ embedding เจือจาง, การ overlap ระหว่าง chunk เพื่อรักษา context ที่อยู่รอยต่อ, และการ chunk ตาม semantic boundary (เช่น ย่อหน้า หรือส่วน) แทนที่จะตัดตามจำนวนตัวอักษรสุ่มๆ ใน RAG pipeline ที่ดี Chunking เป็นขั้นตอนที่ส่งผลต่อคุณภาพคำตอบมากพอๆ กับการเลือก embedding model เอง
Embedding กับ Fine-tuning ต่างกันอย่างไร และควรใช้อันไหน?
Embedding และ Fine-tuning เป็นสองแนวทางที่ต่างกันในการทำให้ AI “เข้าใจ” domain ของคุณ Embedding คือการแปลงข้อมูลเป็น vector เพื่อค้นหาและเปรียบเทียบความหมาย โดยใช้โมเดลที่ train มาแล้ว (pretrained) โดยไม่ต้องแก้ไข weight ของโมเดล ส่วน Fine-tuning คือการนำโมเดลที่ train มาแล้วมาฝึกต่อด้วยข้อมูล domain เฉพาะทาง เพื่อปรับ weight ให้เหมาะสม ในทางปฏิบัติ: ใช้ Embedding + RAG เมื่อต้องการให้ AI ตอบจากเอกสารของคุณโดยตรง, ต้องการอัปเดตข้อมูลบ่อย, หรืองบประมาณจำกัด ใช้ Fine-tuning เมื่อต้องการให้โมเดลรู้จัก terminology เฉพาะทาง, ต้องการ tone ของ output ที่แน่นอน, หรือมีข้อมูล labeled จำนวนมาก สำหรับคนเริ่มต้น RAG + Embedding เป็นจุดเริ่มต้นที่คุ้มค่ากว่า fine-tuning มากในแง่ cost และเวลา
สรุป: Embedding คือ “ภาษา” ที่ทำให้ AI และมนุษย์คุยกันรู้เรื่อง
Embedding คือสิ่งที่เปลี่ยน AI จาก “เครื่องจักรที่จับคู่ตัวอักษร” ให้กลายเป็น “ระบบที่เข้าใจความหมาย” โดยการแปลงทุกคำ ทุกประโยค ทุกเอกสาร ให้กลายเป็นพิกัดในอวกาศหลายมิติที่ความหมายที่ใกล้เคียงกัน = ตำแหน่งที่ใกล้กัน
สิ่งที่คุณได้จากบทความนี้:
- Embedding = vector ตัวเลขหลายมิติที่แทน “ความหมาย” ของข้อความ — ไม่ใช่การจำตัวอักษร
- ปรากฏการณ์ “กษัตริย์ – ผู้ชาย + ผู้หญิง = ราชินี” เกิดได้เพราะ vector จับโครงสร้างความสัมพันธ์ได้จริง
- โมเดลเรียนรู้จาก Distributional Hypothesis — คำที่อยู่ในบริบทเดียวกันมีความหมายใกล้เคียงกัน
- 5 use case หลัก: semantic search, RAG, recommendation system, document clustering, intent detection
- เครื่องมือฟรีที่เริ่มได้วันนี้: OpenAI API, HuggingFace Sentence Transformers, Google Embedding API, Cohere Embed
ก้าวถัดไปสำหรับคนที่อยากลงมือทำ: เริ่มจากการสร้าง semantic search ง่ายๆ ด้วย HuggingFace (ฟรี 100%) หรือถ้าอยากเรียนรู้วิธีนำ Embedding ไปใช้ใน RAG pipeline จริง หลักสูตร สร้าง RAG AI Agent จากข้อมูลของคุณ คือ next step ที่ตรงที่สุด — มันสอนตั้งแต่ embedding → vector database → RAG → deployment ทั้งหมด step by step
และถ้าคุณอยากพัฒนาทักษะ AI stack ให้ครอบคลุมมากกว่านี้ AI Automation Tech Pass (5,990 บาท/ปี) รวมหลักสูตร AI Tech ทั้งหมดไว้ครบจบ ตั้งแต่ Embedding, RAG, AI Agent ไปจนถึง LLM fine-tuning — คุ้มค่ากว่าซื้อทีละคอร์สหลายเท่า
Views: 104


