RAG คืออะไร? อธิบายแบบเข้าใจง่ายใน 5 นาที + ใช้สร้างอะไรได้บ้าง
จากรายงานของ McKinsey Global Survey on AI (2024) พบว่า 65% ขององค์กรทั่วโลกนำ AI มาใช้ในการทำงานแล้ว — เพิ่มขึ้นเกือบ 2 เท่าเทียบกับปีก่อนหน้า แต่ปัญหาที่ทุกทีมเจอเหมือนกันคือ: AI ที่ฉลาดมากกลับ “โกหก” หรือตอบผิดเรื่องข้อมูลภายในองค์กร เพราะมันไม่รู้จักเอกสาร นโยบาย หรือข้อมูลเฉพาะของบริษัทคุณเลย
นั่นคือที่มาของ RAG หรือ Retrieval-Augmented Generation — เทคนิคที่กำลังเปลี่ยนวิธีที่ธุรกิจใช้ AI จากการ “เดาสุ่ม” เป็นการ “ค้นหาก่อนแล้วค่อยตอบ” บทความนี้จะอธิบายให้คุณเข้าใจตั้งแต่ความหมายพื้นฐาน ไปจนถึงการนำไปสร้างของจริงได้ในวันเดียว
RAG คืออะไร? นิยามแบบบ้านๆ ที่จำได้ทันที
RAG (Retrieval-Augmented Generation) คือเทคนิคที่ให้ AI ทำ 2 ขั้นตอนก่อนตอบคำถาม: ขั้นแรกคือ ค้นหาข้อมูลที่เกี่ยวข้อง จากเอกสารที่เราเตรียมไว้ก่อน จากนั้นจึง สร้างคำตอบ โดยอ้างอิงจากข้อมูลที่ค้นเจอ
ลองนึกภาพแบบนี้: ถ้าคุณถามคำถามยากๆ กับเพื่อนคนหนึ่ง เขาอาจตอบจากสิ่งที่จำได้ ซึ่งอาจถูกหรือผิดก็ได้ แต่ถ้าก่อนตอบ เขาขอเวลาไปค้นหนังสือในห้องสมุดแล้วกลับมาบอกคุณโดยอ้างอิงหน้าที่ชัดเจน — นั่นคือ RAG ในชีวิตจริง
เพื่อให้เข้าใจ RAG อย่างถ่องแท้ ขอแนะนำคำศัพท์ที่เกี่ยวข้อง 5 คำที่ต้องรู้:
- LLM (Large Language Model) — โมเดลภาษาขนาดใหญ่ เช่น GPT-4, Claude, Gemini ที่ถูกฝึกมาบนข้อมูลขนาดมหาศาล แต่มีความรู้แค่ถึงวันที่ฝึกเสร็จ (training cutoff)
- Embedding — กระบวนการแปลงข้อความให้กลายเป็นตัวเลขหลายมิติ (vector) ที่แทนความหมายของข้อความนั้น ข้อความที่มีความหมายใกล้เคียงกันจะมี vector ที่ใกล้กันใน space
- Vector Database — ฐานข้อมูลพิเศษที่เก็บ embedding และค้นหา vector ที่ “ใกล้กันที่สุด” ได้อย่างรวดเร็ว เช่น Pinecone, Chroma, Weaviate
- Chunking — การแบ่งเอกสารขนาดใหญ่ออกเป็นชิ้นเล็กๆ ก่อน embed เพื่อให้ค้นหาได้แม่นยำขึ้น
- Retrieval — ขั้นตอน “ค้นหา” ใน RAG นำ vector ของคำถาม มาหา chunk ที่ใกล้เคียงที่สุดใน vector database
ทั้ง 5 คำนี้คือ “ชิ้นส่วน” ของ RAG และบทความนี้จะอธิบายว่าแต่ละชิ้นทำงานอย่างไรในระบบจริง
ทำไม LLM ถึงตอบผิดและ “หลอน” — ปัญหาที่ RAG ถูกสร้างมาแก้
จากการทดสอบของ งานวิจัย “Hallucination is Inevitable” (Xu et al., 2024) บน arXiv พบว่า LLM ทุกตัวในปัจจุบันมีแนวโน้มสร้าง hallucination — คำตอบที่ฟังดูสมเหตุสมผลแต่ข้อเท็จจริงผิด ในระดับที่ไม่สามารถกำจัดได้ด้วย prompt engineering เพียงอย่างเดียว
สาเหตุหลักมาจาก 3 ข้อจำกัดพื้นฐานของ LLM:
- Training Cutoff — LLM รู้จักโลกแค่ถึงวันที่หยุดฝึก เหตุการณ์หลังจากนั้น เช่น ราคาสินค้าล่าสุด นโยบายที่เพิ่งเปลี่ยน หรือข่าวเมื่อวาน — AI ไม่รู้
- No Private Knowledge — LLM ถูกฝึกด้วยข้อมูลสาธารณะบนอินเทอร์เน็ต แต่เอกสารภายในบริษัทของคุณ เช่น คู่มือพนักงาน สัญญาลูกค้า หรือ SOP ไม่มีทางอยู่ใน training data
- Confident Fabrication — เมื่อ LLM ไม่รู้คำตอบ มันไม่ได้บอกว่า “ไม่รู้” แต่มัก “แต่ง” คำตอบขึ้นมาในโทนที่ฟังดูน่าเชื่อถือ นักวิจัยเรียกพฤติกรรมนี้ว่า hallucination
ลองนึกถึงตัวอย่างจริงในองค์กร: คุณถาม AI ว่า “นโยบายลาป่วยของบริษัทเราปีนี้เป็นอย่างไร?” LLM ธรรมดาอาจตอบโดยอ้างอิงกฎหมายแรงงานทั่วไปหรือข้อมูลสมมติที่ฟังดูสมเหตุสมผล — แต่อาจไม่ตรงกับนโยบายจริงของบริษัทคุณเลย
RAG แก้ปัญหานี้ด้วยการ “บังคับ” ให้ AI ตอบจากเอกสารที่คุณให้มาเท่านั้น แทนที่จะให้มันเดาจากความรู้ที่ฝังอยู่ใน parameter
RAG ทำงานอย่างไร? เข้าใจใน 4 ขั้นตอน
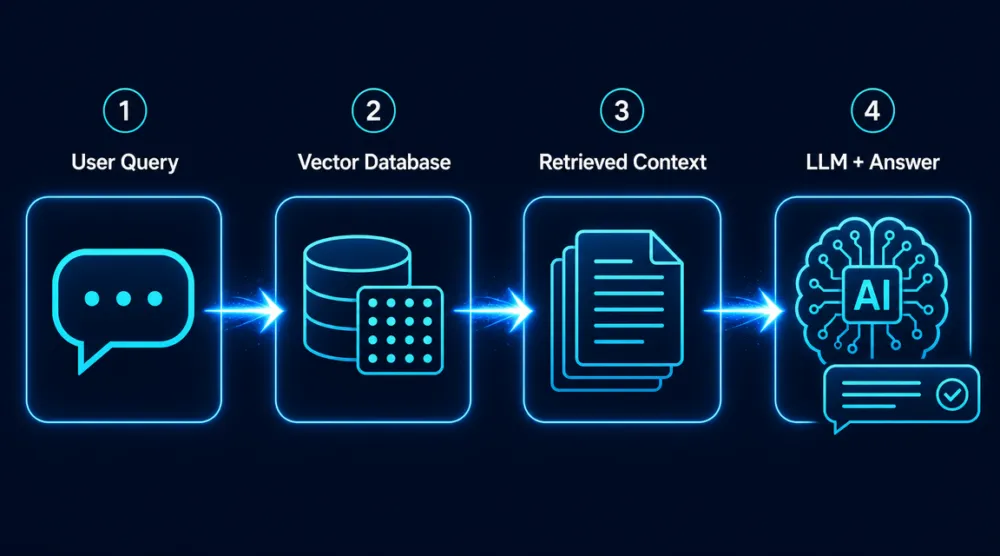
การทำงานของ RAG แบ่งออกเป็น 2 เฟสหลัก คือเฟส Indexing (เตรียมข้อมูล) และเฟส Retrieval + Generation (ค้นหาและตอบ)
เฟส 1: Indexing — เตรียมเอกสารเข้าระบบ
ขั้นตอนที่ทำครั้งเดียว (หรือทำซ้ำเมื่อข้อมูลเปลี่ยน):
- Load เอกสาร — นำเอกสารทุกประเภท (PDF, Word, Markdown, Excel, เว็บไซต์) เข้าระบบ
- Chunk — แบ่งเอกสารเป็นชิ้นเล็กๆ ขนาดประมาณ 200–500 token โดยมักมี overlap ประมาณ 20% เพื่อไม่ให้ context หายที่รอยต่อ
- Embed — ส่งแต่ละ chunk ผ่าน embedding model (เช่น text-embedding-3-large ของ OpenAI) เพื่อแปลงเป็น vector ตัวเลข
- Store — เก็บ vector ทั้งหมดลง vector database พร้อม metadata เช่น ชื่อไฟล์ต้นทาง, หน้า, วันที่
เฟส 2: Retrieval + Generation — ค้นหาและตอบ
ขั้นตอนที่ทำทุกครั้งที่ผู้ใช้ถามคำถาม:
- Query Embedding — นำคำถามของผู้ใช้มา embed ด้วย model เดียวกันกับตอน indexing
- Similarity Search — ค้นหา vector ที่ใกล้เคียงที่สุดใน vector database ดึงมา 3–10 chunk ที่ relevance สูงที่สุด
- Augmentation — นำ chunk ที่ค้นได้มาต่อรวมกับคำถามของผู้ใช้เป็น prompt ที่สมบูรณ์
- Generation — ส่ง prompt ที่มีบริบทแล้วให้ LLM สร้างคำตอบ โดย LLM จะอ้างอิงเฉพาะข้อมูลที่ส่งมาให้
ทั้งหมดนี้เกิดขึ้นในเวลาไม่กี่วินาที ผู้ใช้ปลายทางจะเห็นแค่คำถามและคำตอบที่แม่นยำ — ไม่รู้เลยว่าเบื้องหลังมีกระบวนการซับซ้อนขนาดไหน
3 Use Case จริงที่ RAG ใช้งานได้ทันที
จากการศึกษาของ Gartner (2024) พบว่า use case ที่องค์กรนำ RAG ไปใช้มากที่สุดคือ internal knowledge management (41%), customer support automation (34%) และ document analysis (25%) ต่อไปนี้คือ 3 use case ที่นำไปใช้งานได้จริงในบริบทไทย
Use Case 1: Chatbot เอกสารบริษัท
ปัญหาที่ทุกบริษัทเจอคือ HR ต้องตอบคำถามซ้ำๆ เรื่อง สวัสดิการ, การลา, นโยบาย — คำถามที่คำตอบอยู่ในคู่มือพนักงานอยู่แล้ว ด้วย RAG คุณสามารถนำคู่มือพนักงาน, Employee Handbook, FAQ ที่มีอยู่มา index ลง vector database จากนั้น build chatbot ที่พนักงานถามได้ตลอด 24 ชั่วโมง และได้คำตอบที่อ้างอิงจากนโยบายจริงของบริษัท
ตัวอย่างจริง: บริษัทเทคโนโลยีในไทยรายหนึ่ง นำ RAG มาสร้าง HR chatbot ภายใน 2 สัปดาห์ ลดคำถามที่ HR ต้องตอบด้วยมือลงได้ถึง 60% ในเดือนแรก และพนักงานได้รับคำตอบที่ถูกต้องตามนโยบายจริง ไม่ใช่คำตอบจาก “ความทรงจำ” ของ AI
Use Case 2: Internal Search สำหรับทีม Knowledge-Heavy
ทีม Legal, Compliance, Research หรือ Engineering มักมีเอกสารจำนวนมาก ซึ่งการค้นหาด้วย Ctrl+F หรือ Google Drive search ไม่ตอบโจทย์เมื่อต้องการคำตอบที่สังเคราะห์จากหลายเอกสาร
ด้วย RAG คุณสามารถสร้างระบบ semantic search ที่ค้นหาตาม “ความหมาย” ไม่ใช่ keyword เช่น ถามว่า “มีเอกสารไหนที่พูดถึงเงื่อนไขการยกเลิกสัญญาบ้าง?” แล้วได้รับสรุปจากทุกสัญญาที่เกี่ยวข้อง พร้อม citation ว่าข้อมูลมาจากสัญญาฉบับไหน หน้าที่เท่าไร
สนใจพัฒนาทักษะสร้างระบบ AI agent ที่ทำงานจริงแบบนี้? ดูหลักสูตร สร้าง RAG AI Agent จากข้อมูลของคุณ สู่มันสมองทำงาน 24/7 แทนคน ที่ออกแบบมาให้คุณสร้างได้จริงตั้งแต่ episode แรก
Use Case 3: AI ที่รู้ข้อมูลล่าสุดและ Real-time
LLM ธรรมดามี training cutoff แต่ RAG สามารถ connect กับข้อมูล real-time ได้ เช่น ราคาสินค้าที่อัปเดตทุกวัน, ข่าวสารล่าสุด, หรือ database ที่เปลี่ยนแปลงตลอดเวลา
ตัวอย่างคือ e-commerce ที่ใช้ RAG สร้าง product recommendation chatbot ที่ดึงข้อมูลสต็อกและราคาจริงแบบ real-time แทนที่จะตอบจากความรู้ที่อาจเก่าหรือผิด ทำให้ลูกค้าได้รับข้อมูลที่ถูกต้องและ conversion rate ของ chat ดีขึ้น
ทักษะด้านนี้ยังเชื่อมโยงกับการเป็น Prompt Engineer ที่กำลังเป็นที่ต้องการในตลาดงาน — เพราะการออกแบบ prompt สำหรับ RAG system ต้องการความเข้าใจเรื่อง context management ที่ลึกกว่า prompt ทั่วไป
RAG ต่างจาก Fine-tuning อย่างไร? เลือกแบบไหนดี?
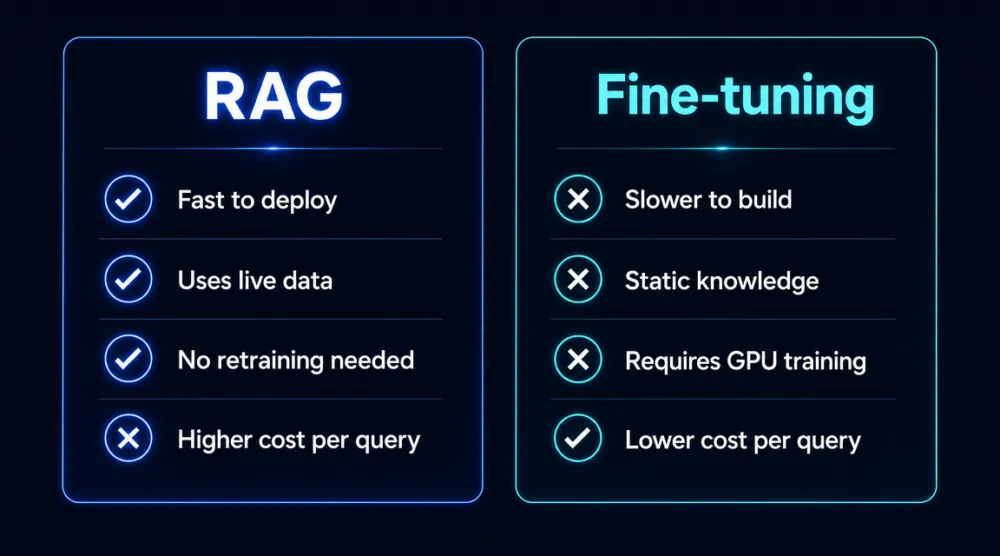
ความสับสนที่พบบ่อยมากคือ “ถ้าอยากให้ AI รู้จักข้อมูลของเรา ต้อง fine-tune หรือ RAG?” — คำตอบขึ้นอยู่กับสิ่งที่คุณต้องการ
Fine-tuning คือการ “ฝึก” โมเดลใหม่ด้วยข้อมูลของคุณโดยตรง ข้อมูลซึมเข้าไปใน parameter ของโมเดล ข้อดีคือโมเดลจะ “รู้สึก” เป็นธรรมชาติในการตอบสไตล์ที่คุณต้องการ แต่ข้อเสียคือ ราคาสูง ใช้เวลานาน และถ้าข้อมูลเปลี่ยนต้อง fine-tune ใหม่
RAG คือการให้ AI ค้นหาข้อมูลก่อนตอบ ข้อมูลอยู่ภายนอกโมเดล อัปเดตได้ง่าย ราคาถูกกว่า และเหมาะกับข้อมูลที่เปลี่ยนบ่อย
สรุปง่ายๆ ว่าควรใช้แบบไหน:
- ต้องการ ข้อมูลที่อัปเดตบ่อย หรือ private knowledge → ใช้ RAG
- ต้องการเปลี่ยน style การเขียน หรือ domain-specific vocabulary อย่างถาวร → ใช้ Fine-tuning
- ต้องการทั้งสองอย่าง → ใช้ RAG + Fine-tuning ร่วมกัน (Hybrid)
ในกรณีส่วนใหญ่สำหรับ use case ขององค์กร RAG เป็นจุดเริ่มต้นที่ดีกว่า เพราะ cost-effective กว่าและ iterate ได้เร็วกว่ามาก
Stack ที่ใช้สร้าง RAG ได้ใน 1 วัน
ข่าวดีคือ ecosystem ของ RAG ในปี 2026 พัฒนามาจนคุณสามารถสร้าง prototype ได้ใน 1 วันจริงๆ ต่อไปนี้คือ stack ที่แนะนำสำหรับแต่ละระดับ
สำหรับผู้เริ่มต้น: No-Code / Low-Code Stack
- Flowise — drag-and-drop UI สำหรับสร้าง RAG pipeline โดยไม่ต้องเขียน code ติดตั้งได้ใน local หรือ deploy ขึ้น cloud
- OpenAI Embeddings — text-embedding-3-small หรือ text-embedding-3-large สำหรับแปลงข้อความเป็น vector
- Chroma — vector database ที่ติดตั้งได้ใน local ฟรี เหมาะสำหรับ prototype
- GPT-4o หรือ Claude — LLM สำหรับ generation ขั้นสุดท้าย
สำหรับ Developer: Python Stack
- LangChain หรือ LlamaIndex — framework หลักสำหรับ orchestrate RAG pipeline ใน Python ทั้งสองตัวมี abstraction ที่ช่วยให้สลับ component ได้ง่าย
- OpenAI / Hugging Face Embeddings — สำหรับสร้าง embedding
- Pinecone หรือ Weaviate — managed vector database สำหรับ production (มี free tier ให้ทดลอง)
- FastAPI — สำหรับสร้าง API endpoint ให้ frontend เรียกใช้
สำหรับ Production Scale
- Azure AI Search หรือ AWS Bedrock Knowledge Base — managed RAG solution จากผู้ให้บริการ cloud รองรับ scale ระดับ enterprise
- Qdrant — vector database open-source ที่ performance ดีมากและ deploy ได้ทุก environment
- Observability: LangSmith หรือ Arize Phoenix สำหรับ monitor คุณภาพของ retrieval และ generation
สำหรับคนที่อยากเรียนรู้วิธี build ทั้งหมดนี้อย่างเป็นระบบ หลักสูตร Building Intelligent Assistants: AI Agent Technology for Modern Business สอนตั้งแต่ concept ไปจนถึง deploy จริง พร้อม hands-on labs ที่ลองทำตามได้ทันที
ข้อผิดพลาดที่พบบ่อยเมื่อสร้าง RAG ครั้งแรก
จากประสบการณ์ของนักพัฒนาที่สร้าง RAG ระบบแรก มักเจอ 5 ข้อผิดพลาดเหล่านี้ซ้ำๆ
1. Chunk ขนาดใหญ่เกินไป — การ chunk ด้วยขนาด 2,000+ token ทำให้ vector มีความหมาย “เจือจาง” เกินไป retrieval ไม่แม่นยำ แก้ไขด้วยการลด chunk size ลงมาที่ 200–400 token และทดสอบว่า retrieval ดีขึ้นไหม
2. ไม่มี metadata ที่ดี — การไม่เก็บ metadata เช่น source, date, section ทำให้ไม่รู้ว่าคำตอบมาจากไหน และ filter ข้อมูลตาม criteria ไม่ได้ ควรเก็บ metadata ให้ครบตั้งแต่ indexing
3. ใช้ embedding model ผิด — ถ้า index ด้วย model A แต่ query ด้วย model B ผลลัพธ์จะผิดเพี้ยนทั้งหมด เพราะ vector space ต่างกัน ต้องใช้ model เดียวกันตลอด
4. ไม่มี evaluation — สร้าง RAG แล้วไม่วัดคุณภาพ เช่น ไม่ทดสอบว่า retrieval ดึงมาถูก chunk ไหม ไม่วัด answer correctness ทำให้ไม่รู้ว่าระบบดีพอสำหรับ production หรือยัง ควรสร้าง test set และวัด recall@k
5. ลืม Guardrail — ไม่มีระบบ fallback เมื่อ retrieval ไม่เจอข้อมูลที่เกี่ยวข้อง ทำให้ LLM กลับไป hallucinate อีก ควรออกแบบ prompt ให้ AI บอกว่า “ไม่พบข้อมูลในเอกสารที่มี” แทนการเดา
หากคุณสนใจเรื่อง AI tools สายนี้เพิ่มเติม บทความ ทำงานสะดวกขึ้น! ด้วย 4 AI Generative ในสายงานที่ต่างกัน ให้ภาพรวมที่ดีว่า AI generative แต่ละประเภทใช้ทำงานอะไรได้บ้าง ก่อนจะลงลึกสู่ RAG
RAG กับ Agentic AI — อะไรคือก้าวถัดไป?
RAG คือ “upgrade” ที่ดีที่สุดสำหรับ LLM ที่ต้องทำงานกับข้อมูลส่วนตัว แต่ในปี 2026 ทิศทางที่น่าสนใจมากขึ้นคือ Agentic RAG — ระบบที่ไม่แค่ “ค้นแล้วตอบ” แต่สามารถ “ตัดสินใจว่าจะค้นอะไร” ได้เอง
ใน Agentic RAG โมเดลสามารถ:
- วางแผนว่าต้องดึงข้อมูลจากแหล่งไหนบ้างก่อนตอบ
- ค้นหาซ้ำหลายรอบถ้ายังไม่ได้ข้อมูลที่ต้องการ (iterative retrieval)
- ตรวจสอบคำตอบตัวเองก่อน output (self-reflection)
- เรียกใช้ tool อื่น เช่น calculator หรือ API เมื่อจำเป็น
เทรนด์นี้เชื่อมโยงกับ Claude Code และ AI Coding Agent ที่กำลังเปลี่ยนวิธีทำงานของนักพัฒนา — ถ้าคุณสนใจว่า AI agent ประเภทต่างๆ ต่างกันอย่างไร บทความ Claude Code คืออะไร และทำไมมันไม่เหมือน ChatGPT จะช่วยให้เห็นภาพใหญ่ขึ้นได้
คำถามที่พบบ่อยเกี่ยวกับ RAG
RAG ต่างจาก Fine-tuning อย่างไร?
RAG และ Fine-tuning เป็นสองวิธีที่แตกต่างกันมากในการทำให้ AI รู้จักข้อมูลเฉพาะของคุณ Fine-tuning คือการ “สอน” โมเดลใหม่ด้วยข้อมูลของคุณโดยตรง เปรียบเหมือนการส่งพนักงานไปอบรมหลักสูตรใหม่ที่ใช้เวลาหลายวันและค่าใช้จ่ายสูง ข้อมูลจะ “ซึม” เข้าไปในน้ำหนักของโมเดล แต่ถ้าข้อมูลเปลี่ยน ต้อง fine-tune ใหม่ทุกครั้ง ส่วน RAG คือการให้ AI “ค้นหา” เอกสารก่อนตอบทุกครั้ง เปรียบเหมือนการให้พนักงานมีคู่มือที่อัปเดตได้ตลอด ข้อมูลเก็บอยู่ภายนอกโมเดล อัปเดตง่ายโดยไม่ต้อง train ใหม่ ค่าใช้จ่ายน้อยกว่ามาก RAG เหมาะเมื่อข้อมูลของคุณเปลี่ยนบ่อย เช่น นโยบายบริษัท สต็อกสินค้า หรือข่าวสาร Fine-tuning เหมาะเมื่อคุณต้องการเปลี่ยน tone หรือ style การตอบของ AI อย่างถาวร ในกรณีส่วนใหญ่ RAG คุ้มค่ากว่าสำหรับ use case ขององค์กร
RAG ต้องใช้ทักษะ programming อะไรบ้างในการสร้าง?
การสร้าง RAG พื้นฐานต้องการทักษะ Python ระดับกลาง สามารถใช้ library หลักได้คือ LangChain หรือ LlamaIndex สำหรับ orchestration, OpenAI หรือ Hugging Face สำหรับ embedding model, และ Chroma, Pinecone หรือ Weaviate สำหรับ vector database ถ้าคุณเขียน Python ได้ในระดับที่ใช้ library ได้ คุณสามารถสร้าง RAG แรกได้ภายใน 1 วัน โดยไม่จำเป็นต้องเข้าใจ math ลึกๆ เบื้องหลัง สิ่งที่ต้องเข้าใจคือ concept ของ vector, embedding และ similarity search ในระดับ conceptual ไม่ใช่ mathematical ปัจจุบันมี no-code solution เช่น Flowise และ Langflow ที่ให้สร้าง RAG pipeline ด้วย drag-and-drop ได้เลย เหมาะสำหรับคนที่ไม่มีพื้นฐาน programming แต่ถ้าต้องการ customize ลึกๆ หรือ deploy ในระดับ production ยังต้องการทักษะ coding อยู่ดี
Vector Database คืออะไร และสำคัญยังไงใน RAG?
Vector Database คือฐานข้อมูลพิเศษที่เก็บข้อมูลในรูปแบบ vector หรือตัวเลขหลายมิติ แทนที่จะเก็บเป็น text ธรรมดา เวลาเราแปลงเอกสารเป็น embedding ข้อความแต่ละชิ้นจะกลายเป็น vector ที่มีมิติหลายร้อยถึงหลายพัน เช่น [0.23, -0.45, 0.12, …] ตัวเลขเหล่านี้แทน “ความหมาย” ของข้อความ ข้อความที่มีความหมายใกล้เคียงกันจะมี vector ที่ “ใกล้กัน” ใน space นั้น Vector Database เช่น Pinecone, Chroma, Weaviate, หรือ Qdrant ถูกออกแบบมาเพื่อค้นหา vector ที่ใกล้ที่สุด (nearest neighbor search) ได้อย่างรวดเร็ว แม้จะมีเอกสารหลายล้านชิ้น นี่คือหัวใจของ RAG เพราะทำให้ระบบสามารถดึงข้อมูล “ที่เกี่ยวข้องที่สุด” กับคำถามของผู้ใช้ออกมาได้ในเวลาไม่กี่มิลลิวินาที ก่อนส่งให้ LLM สร้างคำตอบ
RAG แก้ปัญหา AI หลอน (Hallucination) ได้ 100% ไหม?
RAG ลด hallucination ได้อย่างมีนัยสำคัญ แต่ไม่สามารถกำจัดได้ 100% งานวิจัยจาก Meta AI (2023) พบว่า RAG ช่วยลด hallucination ใน open-domain QA ได้ถึง 73% เมื่อเทียบกับ vanilla LLM อย่างไรก็ตาม ยังมีกรณีที่ RAG อาจยังหลอนได้ เช่น เมื่อ retrieval ดึงเอกสารผิดมา เมื่อ prompt ไม่ชัดเจน หรือเมื่อ LLM ตีความบริบทผิด การออกแบบ RAG ที่ดีต้องรวม guardrail หลายชั้น เช่น source citation ที่ชัดเจน, confidence score, และ fallback เมื่อไม่พบข้อมูลที่เกี่ยวข้อง แทนที่จะให้ AI คาดเดา นอกจากนี้การ chunk และ index เอกสารให้ดียังส่งผลต่อคุณภาพการ retrieval โดยตรง RAG เป็นเครื่องมือที่ดีมาก แต่ต้องออกแบบระบบรอบๆ มันด้วยความรอบคอบ
Chunking คืออะไร และส่งผลต่อ RAG อย่างไร?
Chunking คือกระบวนการแบ่งเอกสารขนาดใหญ่ออกเป็นชิ้นเล็กๆ ก่อนแปลงเป็น embedding เพื่อเก็บใน vector database เพราะ LLM มีข้อจำกัดด้าน context window และการ embed เอกสารทั้งหมดในครั้งเดียวจะทำให้ความหมายละเอียดหายไป วิธี chunking มีหลายแบบ เช่น fixed-size chunking (ตัดทุก N คำ), sentence-based chunking (ตัดตามประโยค), หรือ semantic chunking (ตัดตามความหมาย) ขนาด chunk ที่เหมาะสมมักอยู่ระหว่าง 200–500 token และมักใช้ overlap ประมาณ 10–20% เพื่อไม่ให้ context สำคัญหายไปที่รอยต่อ การเลือก chunk size ที่ผิดส่งผลโดยตรงต่อคุณภาพคำตอบ เพราะถ้า chunk เล็กเกินไป context ไม่เพียงพอ ถ้าใหญ่เกินไป noise มาก retrieval แม่นยำน้อยลง ดังนั้น chunking strategy จึงเป็นหนึ่งใน “art” ของการสร้าง RAG ที่ดี
RAG เหมาะกับธุรกิจขนาดไหน?
RAG เหมาะกับธุรกิจทุกขนาด ตั้งแต่ freelancer คนเดียวไปจนถึงองค์กรข้ามชาติ สิ่งที่ทำให้ RAG เป็นที่นิยมคือ barrier to entry ต่ำและ ROI สูง สำหรับธุรกิจขนาดเล็ก RAG ช่วยสร้าง chatbot ตอบคำถามลูกค้าอัตโนมัติได้โดยไม่ต้องจ้างทีม AI ขนาดใหญ่ สำหรับองค์กรขนาดกลาง RAG ช่วยให้พนักงานค้นหาข้อมูลใน internal docs ได้เร็วขึ้นหลายเท่า ลดเวลาที่ใช้ค้นหาเอกสารซึ่งโดยเฉลี่ยอยู่ที่ 1.8 ชั่วโมงต่อวันต่อคน สำหรับองค์กรขนาดใหญ่ RAG สามารถ scale ได้โดย connect กับ data source หลายแห่งพร้อมกัน ข้อควรระวังคือคุณภาพของเอกสารต้นฉบับ ถ้า input ไม่ดี output ก็ไม่ดี RAG ไม่ใช่ magic ที่แก้ปัญหาทุกอย่าง แต่เป็นระบบที่คุ้มค่ามากเมื่อคุณมีเอกสารที่ดีและรู้ว่าต้องการตอบคำถามประเภทไหน
สรุป: RAG คือ “สมอง” ที่ทำให้ AI ทำงานจริงในองค์กรของคุณ
RAG (Retrieval-Augmented Generation) คือเทคนิคที่ช่วยแก้ปัญหาพื้นฐานที่สุดของ LLM — การไม่รู้จักข้อมูลส่วนตัวของคุณ และการสร้างคำตอบที่ผิดด้วยความมั่นใจสูง ด้วยการ “ค้นหาก่อนแล้วค่อยตอบ” RAG ทำให้ AI กลายเป็นผู้ช่วยที่น่าเชื่อถือได้จริงในงาน
สิ่งที่คุณได้จากบทความนี้:
- RAG = Retrieve ก่อน → Augment prompt → Generate คำตอบ ไม่ใช่การ fine-tune โมเดล
- ปัญหา hallucination เกิดจาก LLM ไม่มีข้อมูล private และมี training cutoff
- RAG แก้ด้วยการ index เอกสารและดึงมาเป็น context ก่อนตอบทุกครั้ง
- 3 use case จริง: HR chatbot, internal search, real-time data AI
- stack เริ่มต้น: Flowise + Chroma + OpenAI ใช้ได้ใน 1 วัน
ถ้าคุณพร้อมลงมือสร้าง RAG ระบบแรก หลักสูตร สร้าง RAG AI Agent จากข้อมูลของคุณ สู่มันสมองทำงาน 24/7 แทนคน บน FutureSkill พาคุณจาก concept ไปถึง deploy จริงได้แบบ step-by-step หรือถ้าอยากเรียนรู้ AI tech stack หลากหลายมากกว่านี้ AI Automation Tech Pass (5,990 บาท/ปี) รวมหลักสูตร AI สายเทคโนโลยีไว้ครบจบในที่เดียว คุ้มค่ากว่าซื้อทีละคอร์สหลายเท่า
Views: 537


